Eine generative KI-Suche fürs Intranet entwickeln und betreiben
Die Aufgabe
Ein Dokument im Intranet zu finden kostet Zeit. Bei tausenden Dokumenten ist das kein Ärgernis, sondern ein Kostenblock.
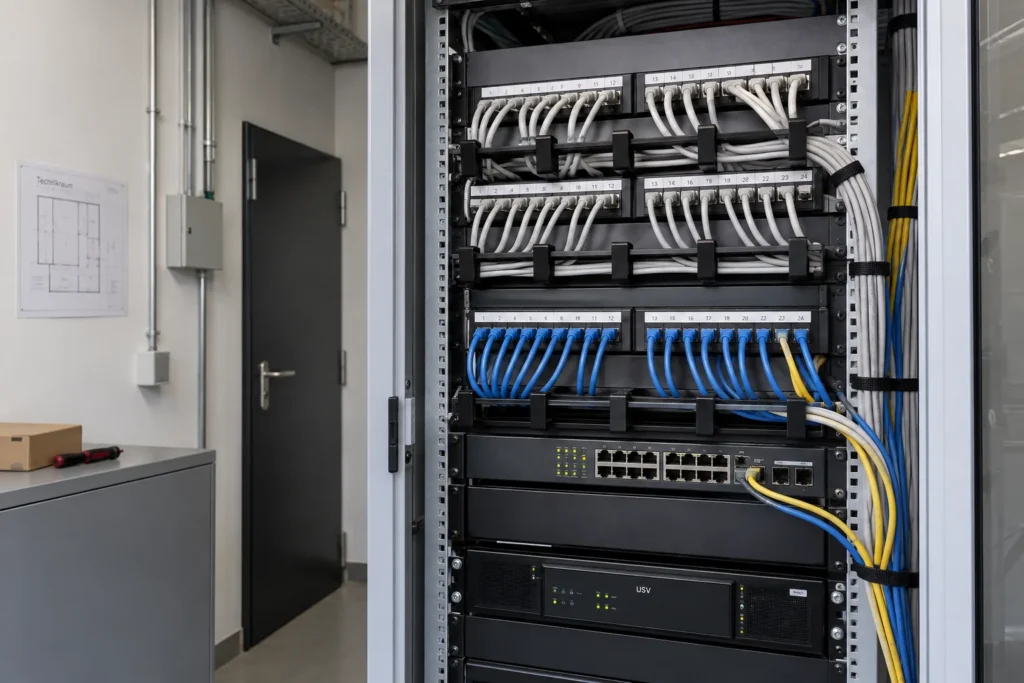
das System läuft seit der Übergabe auf den Servern des Unternehmens
vom Angebot bis zur Fassung, die auf der Leitmesse der Branche live vorgeführt wurde
die läuft heute auf einem im Haus betriebenen Sprachmodell — die Dokumente hatten es ohnehin nie verlassen
Kurz zum Kunden
Wohnungs- und Entwicklungsgesellschaft mit einer über neunzigjährigen Geschichte, eine der größten ihres Bundeslandes. Das Haus bewirtschaftet Wohn- und Gewerbeimmobilien, entwickelt ganze Quartiere und entwickelt selbst. Digitalisierung ist dort kein neues Thema — das Unternehmen gilt in seiner Branche als früh dran und sucht seine Vorhaben selbst, statt sie sich verkaufen zu lassen. Entsprechend ist der Ausgangspunkt nicht die Frage, ob Künstliche Intelligenz eingesetzt wird, sondern wo sie zuerst etwas einbringt.
Unsere Lösung
Die Dokumente bleiben im Haus. Hinaus geht nur, was für die eine Antwort gebraucht wird — und später nicht einmal mehr das.
Die Aufgabe
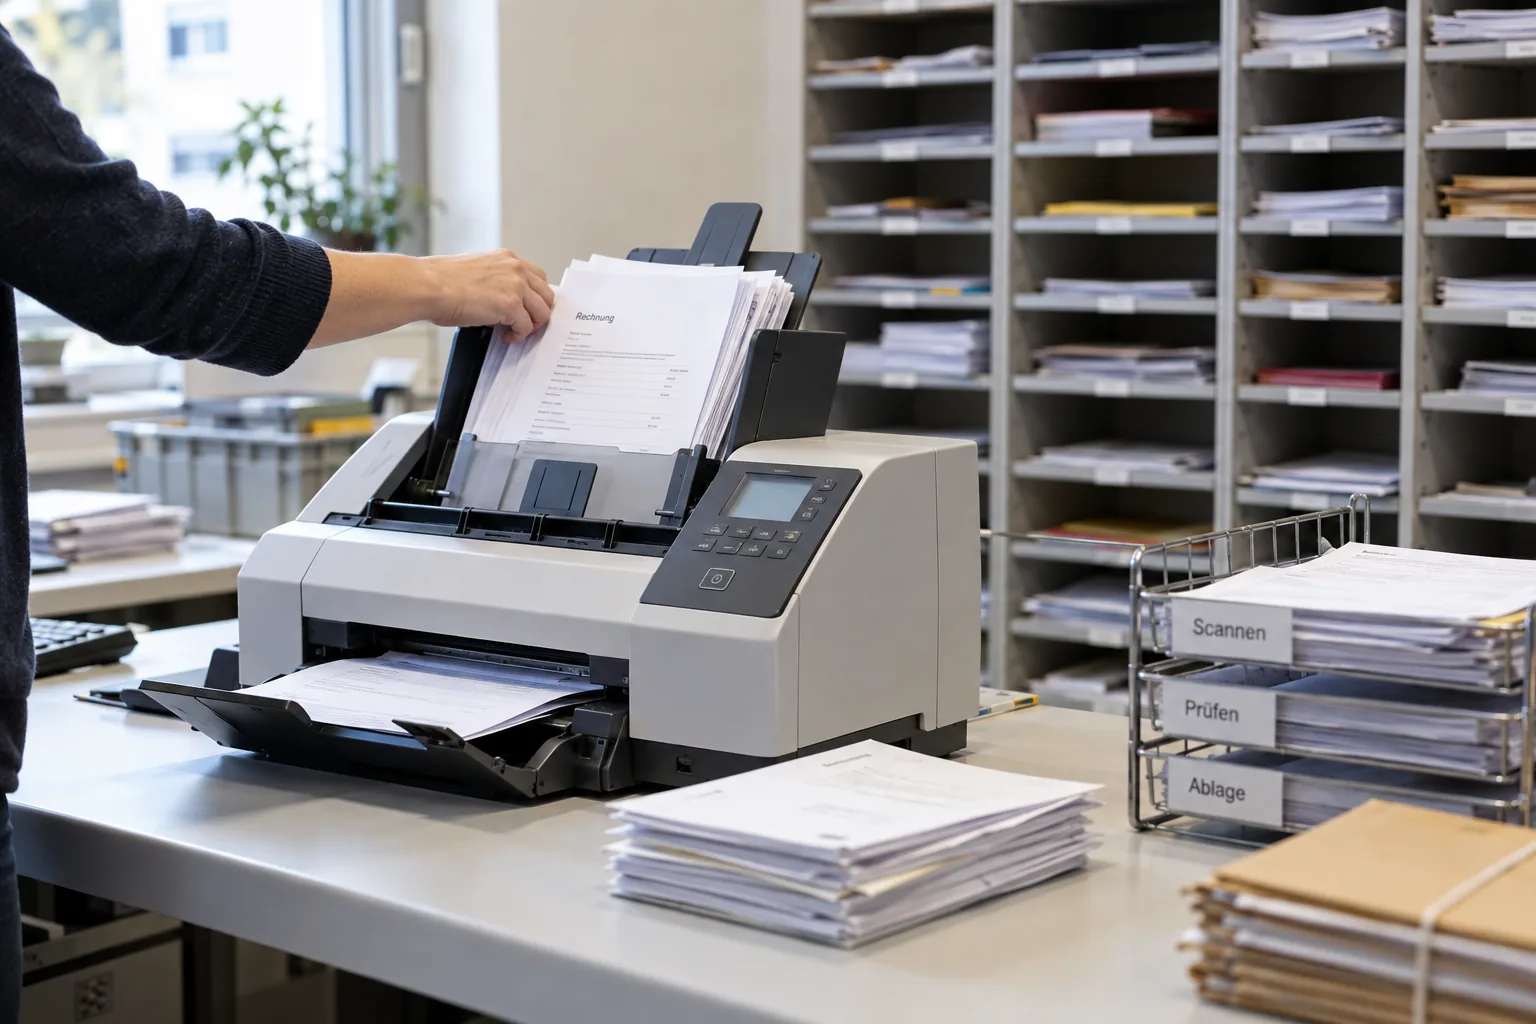
Das Haus hat sich vorgenommen, Künstliche Intelligenz nicht als Studie zu behandeln, sondern an einer Stelle anzufangen, an der sie sofort etwas einbringt. Die Wahl fällt auf die Suche im eigenen Intranet — nicht weil sie technisch reizvoll ist, sondern weil sie täglich Zeit kostet und damit rechenbar wird. Gesucht ist ein System, das Mitarbeitende in normaler Sprache nach Inhalten aus unternehmensinternen Dokumenten fragen können und das ihnen eine Antwort gibt, deren Herkunft nachvollziehbar ist. Zwei Bedingungen machen die Aufgabe anspruchsvoll. Erstens darf der Dokumentenbestand das Haus nicht verlassen. Zweitens gibt es einen Termin, der sich nicht verschieben lässt: Auf der Leitmesse der Immobilienwirtschaft soll die Lösung am Stand des Unternehmens live gezeigt werden. Vom Angebot bis dahin bleiben gut fünf Wochen.
Unser Ansatz
Der Bestand verlässt das Haus nicht. Die Dokumente, ihre Abschnitte und die Bedeutungsvektoren liegen auf den Servern des Unternehmens. An das Sprachmodell gehen ausschließlich die wenigen Textabschnitte, die die Ähnlichkeitssuche für genau diese eine Frage gefunden hat — und seit der Umstellung auf ein lokal betriebenes Modell verlassen auch diese das Haus nicht mehr. Das ist der Unterschied zwischen einem System, das ein Datenschutzbeauftragter freigeben kann, und einem, das man abschalten muss, sobald jemand genauer hinsieht.
Jede Antwort trägt ihre Quelle. Beim Zerlegen der Dokumente werden Herkunftsangaben mitgeführt, und sie erscheinen in der Antwort. Das klingt nach einer Kleinigkeit und entscheidet über die Benutzbarkeit: Wer in einer Wohnungswirtschaft eine Auskunft aus einer Betriebskostenrichtlinie weitergibt, muss zeigen können, woher sie stammt. Ein System, das plausibel klingende Antworten ohne Herkunft liefert, wird nach der dritten Nachfrage nicht mehr benutzt.
Ein Messetermin als Disziplin. Zwischen Angebot und der Leitmesse der Branche lagen gut fünf Wochen, und der Termin war nicht verhandelbar. Das erzwingt eine Entscheidung, die in Innovationsprojekten sonst vertagt wird: Was gehört zur ersten einsatzfähigen Fassung und was nicht. Entwickelt wurde der Kern — Dokumente hinein, Frage, belegte Antwort — und alles andere kam danach.
Der Anbieterzugang wurde nachgeholt, nicht vorausgesetzt. In der ersten Fassung lief die über einen allgemeinen Zugang. Kurz darauf wurde eine eigene Instanz des Sprachmodells eingerichtet, getrennt betrieben, mit Wartung und Zugangskontrolle nach den Grundschutzanforderungen des Bundesamts. Diese Reihenfolge ist bewusst: Erst wird nachgewiesen, dass die Suche brauchbare Antworten liefert, dann wird der Betrieb eingerichtet, den sie verdient. Umgekehrt kauft man Infrastruktur für ein System, das es noch nicht gibt.
Übergeben wird das System und die Fähigkeit, es zu betreiben. Zum Lieferumfang gehört eine Betriebsdokumentation, die beschreibt, wie die Bestandteile zusammenhängen, wo die Konfiguration liegt, wie Protokolle gelesen und Zertifikate erneuert werden. Der Auftrag war von Anfang an so angelegt, dass er neben der Entwicklung den Wissensaufbau im Haus vorantreibt — damit die nächsten KI-Vorhaben dort beginnen können und nicht wieder bei uns.
Das Ergebnis
Ein System, das seit der Übergabe im Einsatz ist, aufgebaut aus drei Verbünden.
Das sind ein Backend mit der eigentlichen Fachlogik, ein Synchronisationsdienst, der die Dokumente aus dem Ablagesystem des Hauses zieht, und eine Weboberfläche. Der Weg einer Frage geht so: Die Dokumente werden in Abschnitte zerlegt, mit Herkunftsangaben versehen und in zwei Datenbanken abgelegt — die Texte samt Metadaten in einer klassischen, die Bedeutungsvektoren in einer Vektordatenbank. Eine Frage in Freitext, mit Vorauswahl der Wissensbasis, wird in denselben Vektorraum übersetzt; die Ähnlichkeitssuche findet die passenden Abschnitte, und erst diese wenigen Originalabschnitte gehen zur Formulierung der Antwort an das Sprachmodell.
Die Antwort kommt mit Quellenangabe zurück. Später ist das Sprachmodell ins eigene Haus geholt worden: Die läuft heute auf einem lokal betriebenen Modell, zuvor auf einer eigenen, vom Anbieter getrennten Instanz, betrieben nach den Grundschutzanforderungen des Bundesamts für Sicherheit in der Informationstechnik, mit Wartung, Aktualisierung und Zugangskontrolle. Übergeben worden ist nicht nur das System, sondern auch eine Betriebsdokumentation, mit der die IT des Hauses es selbst betreiben kann.
Diese Leistungen steckten im Projekt
Weitere Projekte
Alle Referenzen ansehen
Kontakt
Sprechen Sie uns an
Schreiben Sie uns eine Zeile. Wir ordnen Ihre Frage ein und melden uns.